背景
数字档案馆已经解决了“存”和“查目录”,但档案内容仍是黑箱:一份年鉴里有哪些事件、哪些单位,需要人工通读。
档案编研长期依赖人工摘抄,年鉴、史志、大事记的口径与格式要求严格,产出慢且难复用。
做法
- 按文书、科技、会计等 7 类档案分别设计抽取模板,大模型 + 小模型 + 专家规则融合,兼顾泛化与准确。
- 在抽取结果上做语义检索与关系挖掘,把检索粒度从目录下探到段落。
- 面向年鉴、史志、大事记、组织沿革四类编研场景,用 AIGC 生成符合规范的专业编研内容。
- 结合时间与档案类型维度做词频统计与趋势可视化,辅助发展研判。
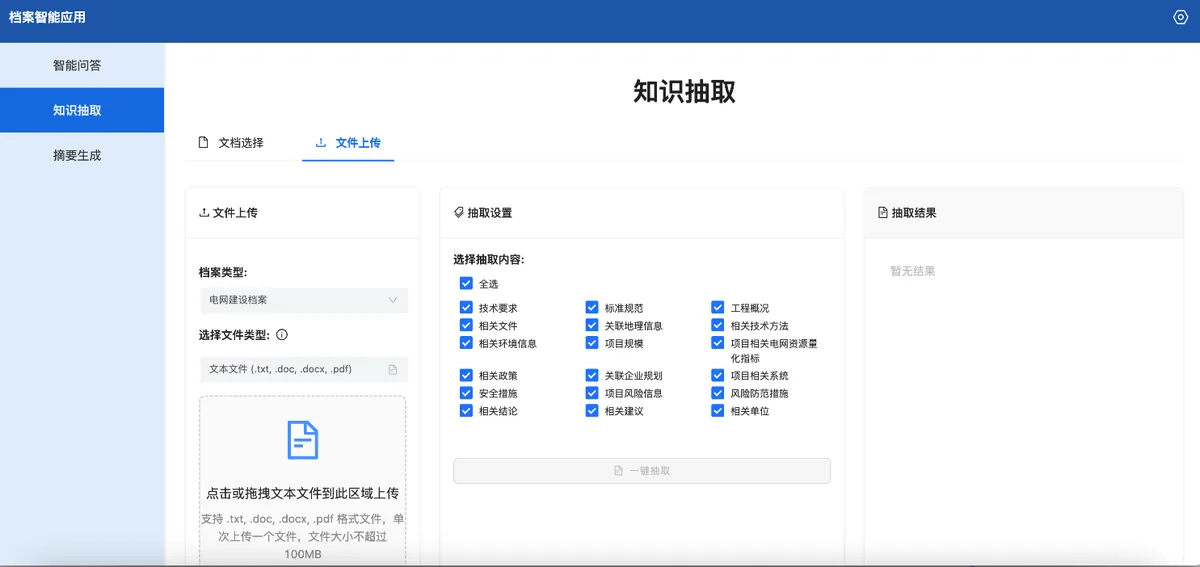
档案抽取结果与编研内容生成界面
结果
- 7 类档案具备可配置的抽取模板,新增档案类型可按模板扩展。
- 检索从目录级下探到段落级,可定位到具体表述与出处。
- 四类编研场景可由系统生成初稿,人工做审校与定稿。
7 类
档案类型覆盖
4 类
编研场景
段落级
检索粒度
本项目为档案数据生成式 AI 应用能力建设,以上为能力覆盖范围,不等同于运行期性能统计;如需引用具体效果数据,以双方确认的验收材料为准。
把你的业务,交给可信的智能体
预约演示或直接邮件联系,我们会按您的行业场景准备材料。